llm-eval
LLMアプリやAIエージェントの品質を測るために、評価ケース、採点方法、実行基盤を作ります。既存の評価がある場合は、ケースと採点結果を監査して再利用できる部分を確認します。
渡す情報
対象の機能、実際の処理の入口、入力例、期待する結果、守りたい品質を渡します。モデルやプロンプトを比較する場合は、実行回数と費用の範囲も伝えます。
依頼例
llm-evalを使って、問い合わせ分類の評価を作ってください。請求とアカウントの分類を対象に、ケースと採点方法をHTMLで確認したいです。評価の実行前に、対象ケースと回数・費用を合意してください。
進め方
- 対象機能と品質基準を整理し、正常系・境界・失敗例を含むケースを用意します。
- 採点方法を決め、ケースと基準をHTMLで確認して実行範囲を合意します。
- 実際の処理を呼ぶrunnerとgraderを作り、少数ケースで検証します。
- 出力と採点根拠、点数推移、エラーをHTMLで確認し、ベースラインを残します。
成果物の例
同梱の架空の問い合わせ分類2ケースから、確認用HTMLを実際に生成した例です。実モデルでの評価は実行していません。
到達点:評価前の確認用HTML生成済み・基準合意とモデル評価は未実施。
移行時の確認:既存の実行記録を移行しました。本文の一致は確認しましたが、過去の実行時の同梱資料全体は特定できていません。
このハッシュは移行時の変更検出用の基準です。同梱資料全体をこの版で再実行した証拠ではありません。
実行した依頼
入力データは `utils/skills/development/llm-eval/assets/example-review-data.json` の同梱サンプルです。同じ内容を `review-data.json` として保存しています。問い合わせ分類の架空の2ケースを含み、評価実行結果は空です。

スキルのディレクトリから次のコマンドを実行しました。

python3 scripts/build_review.py --data assets/example-review-data.json --output ../../../../docs/artifacts/examples/llm-eval/review.html

これは配置後のHTML生成確認です。モデル評価や、人間が合意した基準による評価実行は含みません。
実際の画面
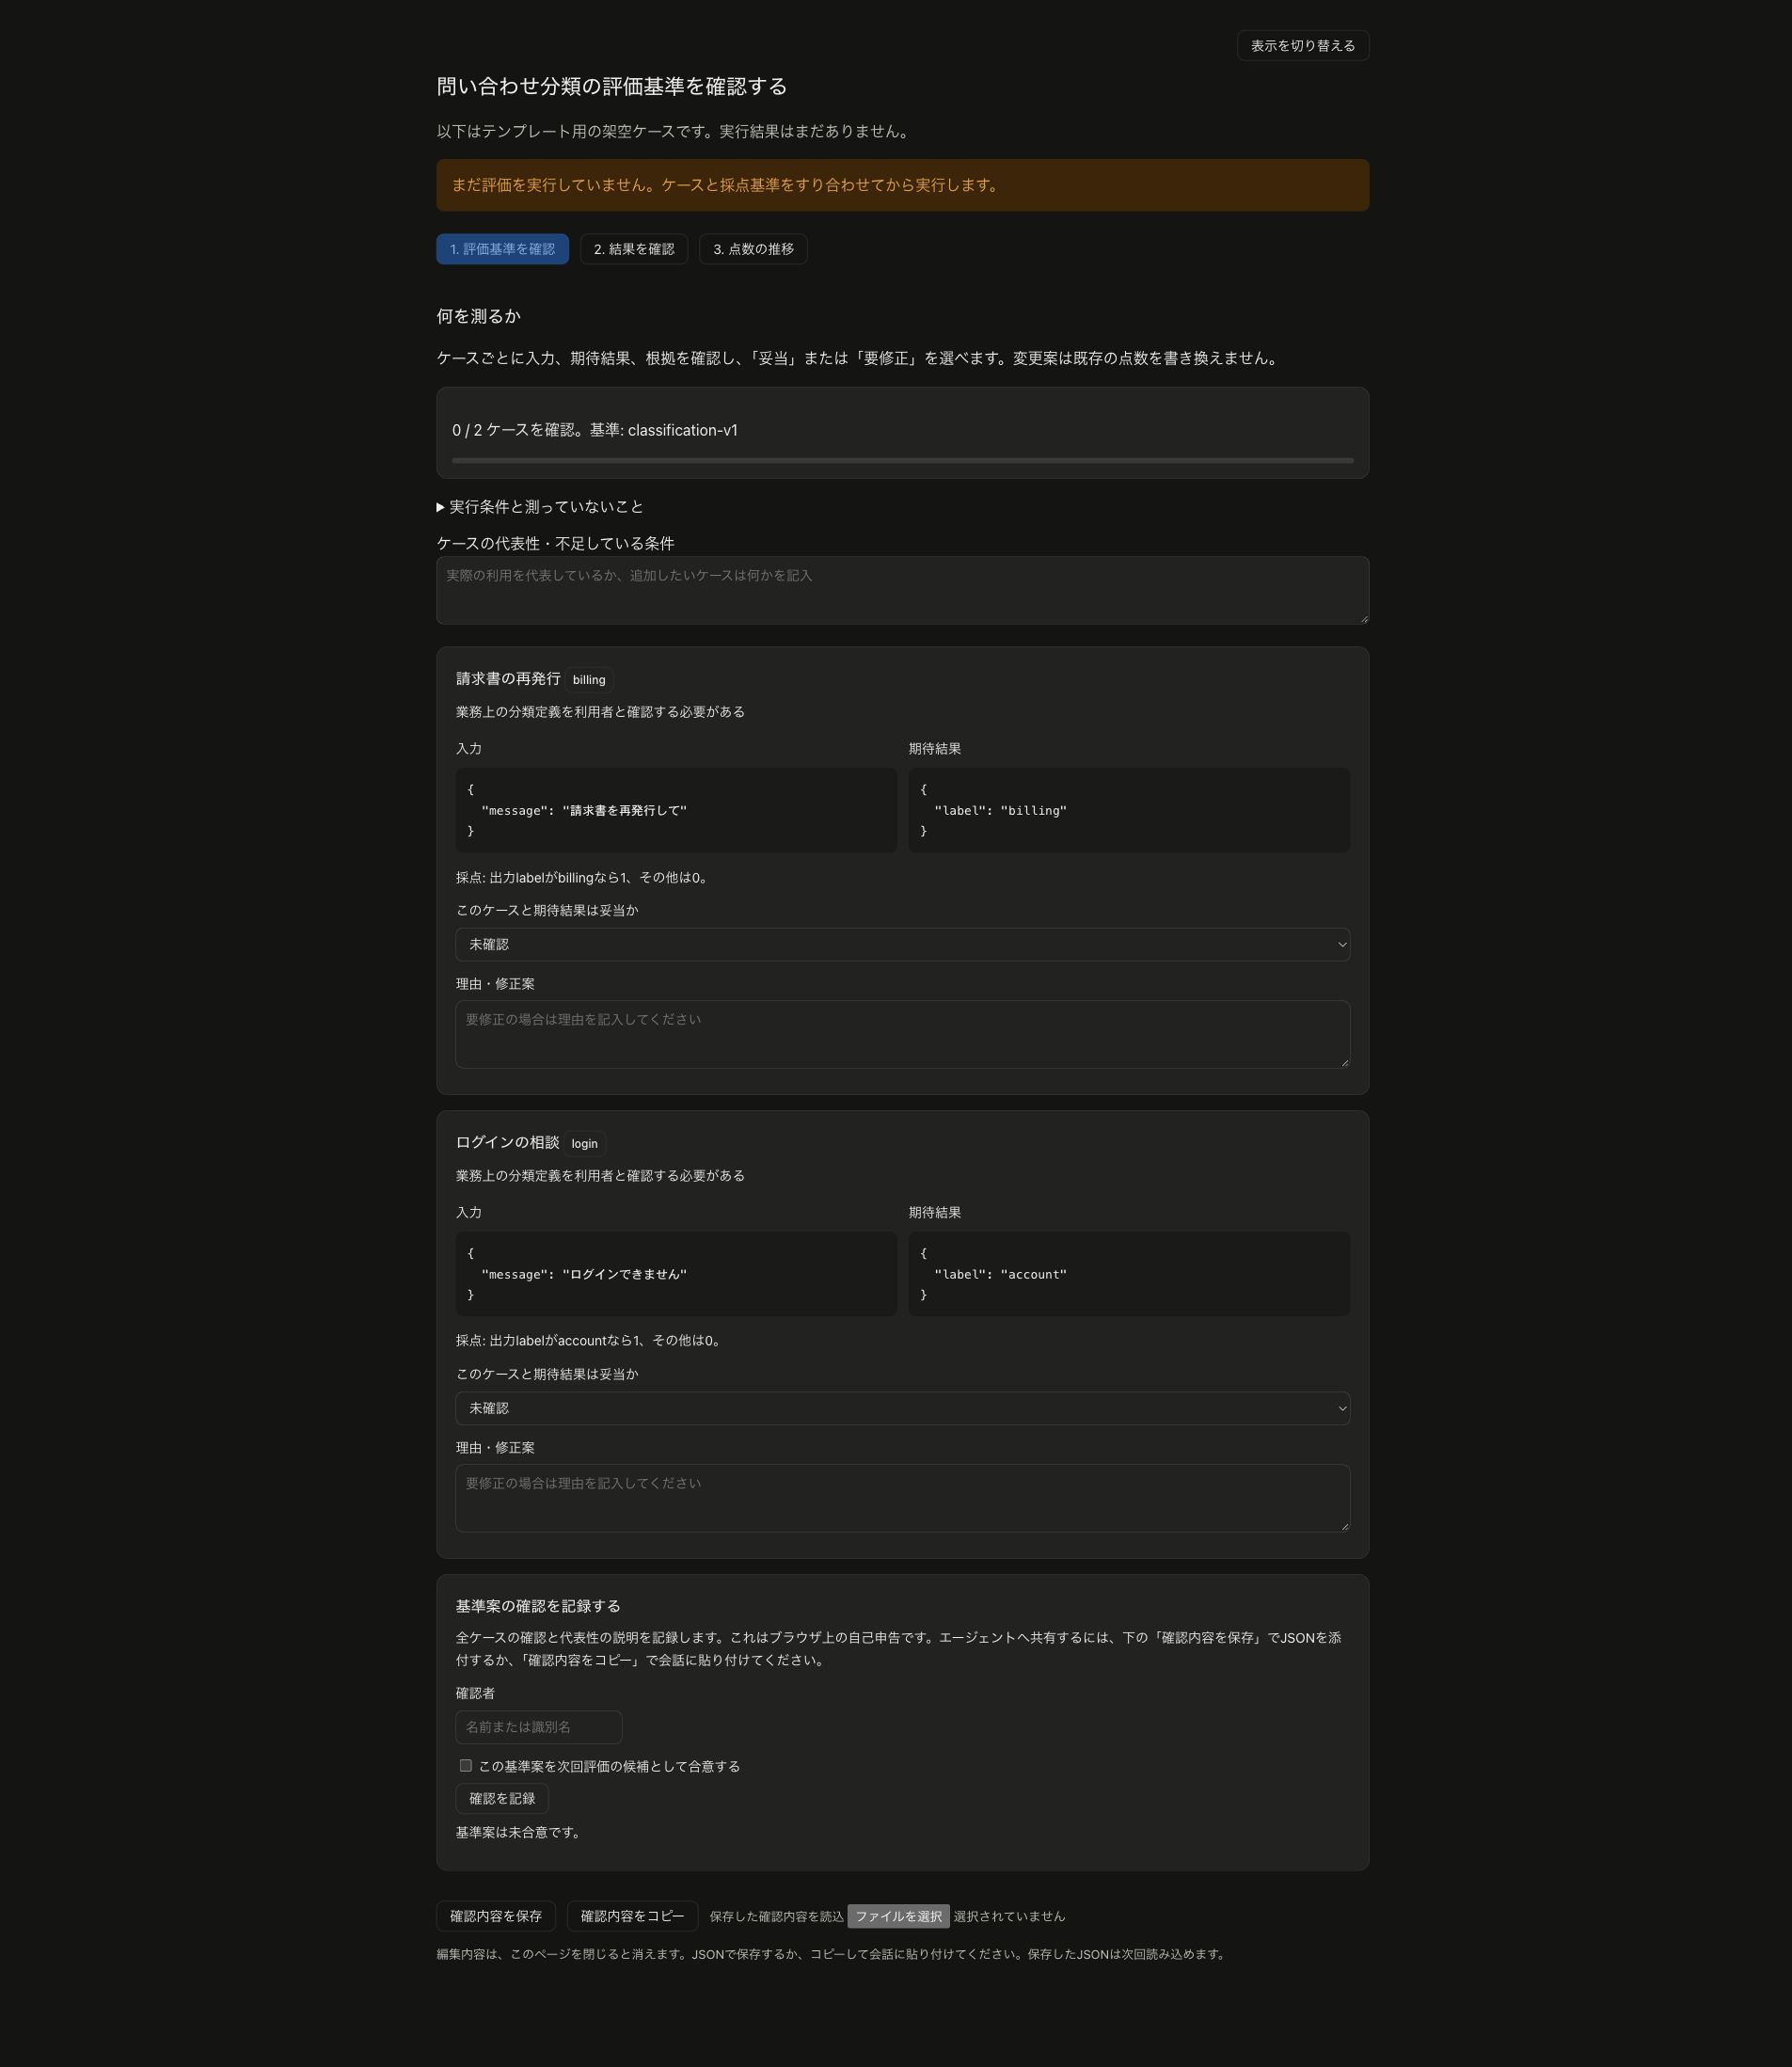
同梱の架空ケースを使った評価前の画面です。実モデルの評価結果ではありません。
成果物を取得する
確認した結果
- 移動先のbuild_review.pyでHTML生成に成功。
- 生成HTMLの埋め込みJSONを入力と照合し、2ケース・評価実行0件を確認。
- Chromeで確認用HTMLを表示し、スクリーンショット原本を保存。
確認するポイント
ケースが実際の仕事を代表しているか、採点方法が正解と不正解を判別できるかを確認します。API失敗や途中で切れた出力は、不正解と分けて扱います。
掲載した実例は、同梱の架空ケースから確認用HTMLを生成したものです。実モデルでの評価、採点器の校正、人間による基準の合意は未実施です。同梱のHTML生成スクリプトはrunnerやgraderを実行しません。
正本を読む
詳細な手順と制約はllm-evalのSKILL.mdを参照してください。